Uma aplicação útil de IA na pesquisa é ajudar a separar termos, organizar documentos e revisar código de preparação de dados. Esse trabalho continua diferente de validar uma descoberta científica. Para aprender, comece com um problema de leitura e um arquivo pequeno cujo conteúdo você consegue conferir.
Este guia foi revisado em 2 de outubro de 2026. O exemplo de CSV é original, sintético e destinado à organização de referências. Ele não contém dados de pacientes, sequências biológicas ou previsões de moléculas.
O caso e a data correta
Em 10 de setembro de 2026, a OpenAI publicou o relato do laboratório de César de la Fuente. A fonte descreve o uso de modelos do próprio laboratório na busca por candidatos antimicrobianos e de ChatGPT e Codex para ideias, programação e preparação de dados. Identificar um candidato não demonstra que ele se tornou um medicamento.
O texto também aponta etapas posteriores: atividade contra o alvo, quantidade necessária, efeito em células humanas, toxicidade, resistência, fabricação e ensaios clínicos. O aprendizado que vamos transferir é mais limitado: construir uma trilha de leitura e de preparação de arquivos que outra pessoa consiga revisar.
A publicação cita uma análise sobre resistência antimicrobiana no Lancet, de 2024. O registro do estudo no PubMed permite conferir título, DOI e datas. Esse contexto científico não é um resultado obtido pela Aulas de IA.
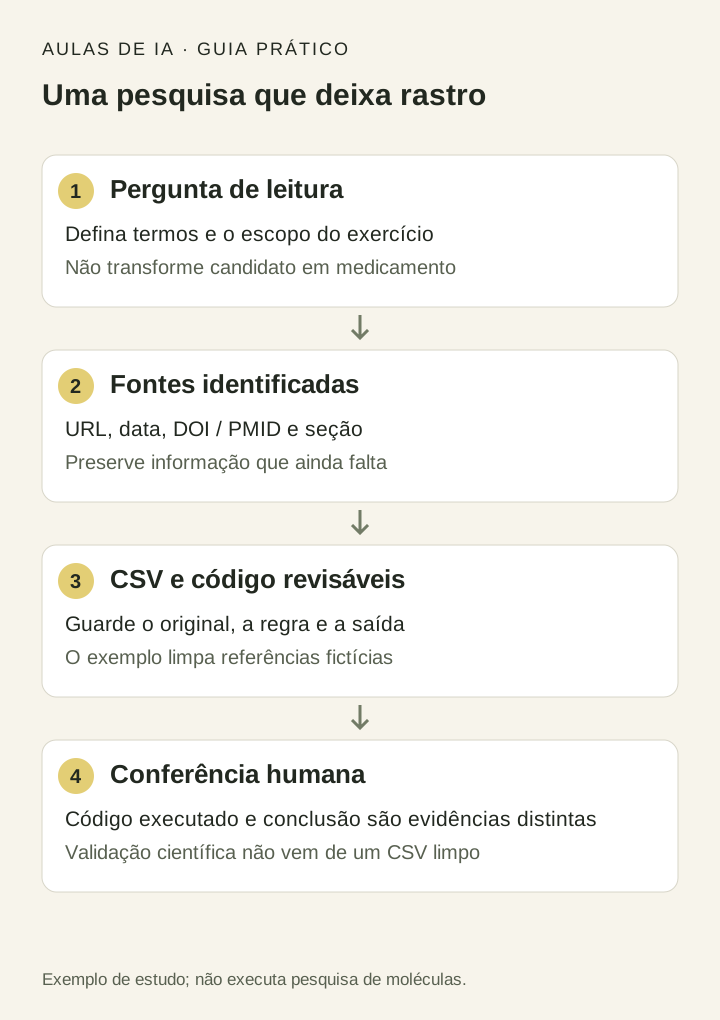
1. Clarifique termos antes de juntar conclusões
Escolha um trecho público que você está tentando entender. Peça que a IA organize um glossário com o termo, a definição que a fonte sustenta e uma pergunta pendente. Não peça apenas uma explicação “simples”: isso pode apagar diferenças importantes entre hipótese, resultado experimental e uso clínico.
Use este trecho público e seu endereço. Explique os termos que preciso para ler o texto. Para cada termo, separe definição sustentada pelo trecho, interpretação didática e informação que depende de outra fonte. Não invente referências. Mostre quando dois termos parecidos descrevem etapas diferentes de uma pesquisa.
Confira as definições no texto original ou em uma referência adequada. Se “candidato” virar “tratamento comprovado” na resposta, há uma mudança de significado que precisa ser corrigida.
2. Compare métodos com a mesma ficha
Para duas publicações, use os mesmos campos: pergunta, dados usados, método descrito, validação realizada, limitações e identificação da fonte. Uma tabela comparável ajuda mais que dois resumos com estruturas diferentes.
Compare estes dois documentos públicos pelas categorias pergunta, dados, método, validação e limites. Cite o documento e a seção que sustentam cada campo. Se uma informação não estiver no material fornecido, deixe a lacuna explícita. Não transforme rapidez de preparação de dados em eficácia científica, nem resultado de uma etapa em validação de outra.
O exercício termina com perguntas melhores, não com uma classificação automática de qual pesquisa é “a melhor”. Preserve desacordos e diferenças de escopo.
3. Organize uma tabela de leitura
Crie um CSV com campos simples. No exemplo abaixo, as linhas são fictícias. Os códigos A e B não são estudos reais e não devem aparecer como citações em um relatório.
id,titulo,ano,url
A, Exemplo de leitura A ,2024, https://example.org/estudo-a
B,Exemplo de leitura B,2025,https://example.org/estudo-b
A, Exemplo de leitura A ,2024, https://example.org/estudo-a
O problema didático é limpar espaços e reconhecer uma repetição exata da identificação. Não é selecionar candidatos antimicrobianos, avaliar eficácia ou preencher dados científicos ausentes.
4. Peça um programa pequeno e legível
Um pedido possível ao Codex é:
Crie um script Python que leia referencias.csv, preserve o original, confira as colunas id, titulo, ano e url, remova apenas linhas repetidas pelo mesmo par id e url e escreva referencias-limpas.csv. Não consulte a internet, não invente URLs e não complete campos vazios. Mostre um resumo das linhas lidas e preservadas. Inclua uma forma de testar com os dados fictícios do exercício.
Um exemplo de implementação para essa tarefa é:
import csv
from pathlib import Path

origem = Path("referencias.csv")
destino = Path("referencias-limpas.csv")
campos = ["id", "titulo", "ano", "url"]
vistos = set()
linhas = []

with origem.open(encoding="utf-8", newline="") as arquivo:
    leitor = csv.DictReader(arquivo)
    if leitor.fieldnames != campos:
        raise ValueError("Colunas diferentes das esperadas")
    lidas = 0
    for linha in leitor:
        lidas += 1
        limpa = {campo: (linha.get(campo) or "").strip()
                 for campo in campos}
        if not limpa["id"] or not limpa["url"]:
            raise ValueError("ID ou URL ausente; revise a origem")
        chave = (limpa["id"], limpa["url"])
        if chave not in vistos:
            vistos.add(chave)
            linhas.append(limpa)

with destino.open("w", encoding="utf-8", newline="") as arquivo:
    escritor = csv.DictWriter(arquivo, fieldnames=campos)
    escritor.writeheader()
    escritor.writerows(linhas)

print({"lidas": lidas, "preservadas": len(linhas)})
Para as três linhas fictícias mostradas, o comportamento esperado é ler três e preservar duas. Isso verifica a limpeza do arquivo e a regra de repetição escolhida. Não verifica se uma URL existe ou se duas referências representam a mesma publicação. Abra e confira os documentos separadamente.
Antes de aplicar a regra a um arquivo real, decida o que significa duplicação no seu projeto. Um registro corrigido e uma versão anterior podem exigir preservação das duas linhas. Não adote uma regra de deduplicação sem entender a informação que ela remove.
5. Confira código e conteúdo separadamente
Guarde o original, o script, a saída e a regra adotada. Compare uma amostra linha a linha e examine os erros. Se o script recusar um campo obrigatório ausente, corrija a origem ou registre a lacuna; não peça ao modelo que invente um valor para fazer o teste passar.
O fato de o código rodar não mostra que a interpretação científica está correta. A revisão de um programa e a revisão de uma afirmação exigem evidências diferentes.
Uma checklist para não pular etapas de validação
Ao ler uma pesquisa sobre candidatos antimicrobianos, transforme cada afirmação em uma pergunta com fonte:
| Pergunta | O que procurar no documento | O que não concluir sozinho |
|---|---|---|
| A atividade contra o alvo foi demonstrada? | Experimento e condições descritos | Uma previsão não equivale ao experimento |
| Que quantidade foi avaliada? | Unidade, faixa e método da fonte | Não propor uma dose para uso humano |
| Houve avaliação em células humanas? | Modelo e resultado informado | Não extrapolar para segurança clínica |
| A toxicidade foi estudada? | Teste, limites e etapa | Ausência de relato não prova ausência de risco |
| A resistência foi investigada? | Estratégia e observações | Não prometer que ela não ocorrerá |
| A fabricação é viável e consistente? | Processo e controle descritos | Não presumir produção por existir uma sequência |
| Existem ensaios e situação regulatória? | Identificação e etapa verificáveis | Não tratar candidato como medicamento aprovado |
Essa é uma ficha de leitura, não um protocolo de laboratório ou orientação para fabricar, testar ou usar uma substância. Quando a fonte não responder, registre “não informado” e leve a pergunta à pessoa com a competência adequada.
Escolha um recurso real para continuar
Veja ChatGPT para Pesquisar para aprofundar organização de perguntas e fontes. Para desenvolver uma rotina de revisão de instruções e resultados, consulte ChatGPT Workflows. O guia de agentes de IA e automação é um recurso complementar para entender o papel de ferramentas.
Esses links pertencem ao catálogo atual; não anunciam um curso de descoberta de fármacos nem uma validação do caso do laboratório. Escolha a próxima aula pelo trabalho que quer aprender, e confira a oferta vigente quando precisar de mais acesso.
Datas, fontes e limites
O relato da OpenAI é de 10 de setembro de 2026. O estudo do Lancet citado pela fonte tem publicação online em 16 de setembro de 2024. Nossa revisão é de 2 de outubro de 2026. As três datas descrevem eventos diferentes.
O CSV, o programa, os prompts e o diagrama são exemplos originais. Não reproduzimos o fluxo de um laboratório, não executamos uma busca de moléculas e não apresentamos resultados científicos ou ganhos de desempenho próprios. Ao praticar o código, registre sua execução e mantenha suas conclusões dentro daquilo que foi realmente conferido.