Local o API: elegir por el trabajo
Un modelo de pesos abiertos puede tener sentido si necesitás controlar dónde se ejecuta, reproducir una configuración o trabajar sin una conexión tras la descarga. La API puede simplificar operación y escalado, pero usa las condiciones del proveedor. Ninguna opción garantiza privacidad por su nombre.
GPT-OSS se anunció el 5 de agosto de 2025. Los modelos base son gpt-oss-20b y gpt-oss-120b; no son ChatGPT ni se ofrecen como esos modelos en la API de OpenAI. Los proveedores externos pueden ofrecer hosting. La licencia y la política de uso también se revisan.
Memoria no es tamaño de descarga
La ficha actual de Ollama muestra aproximadamente 14 GB para la descarga de 20b y 65 GB para 120b. OpenAI describe 16 GB de memoria para 20b y una GPU de 80 GB para 120b bajo su configuración cuantizada. No son una garantía de velocidad o de memoria suficiente para cualquier contexto y runtime.
Dejá margen para sistema, runtime, caché y contexto. Comprobá GPU, memoria y disco antes de descargar. La variante 120b no es una prueba ligera para una computadora habitual. No confundas un tag cloud con una ejecución local.
| Modelo | Descarga en Ollama | Referencia de memoria | Elección práctica |
|---|---|---|---|
| gpt-oss:20b | Aproximadamente 14 GB | 16 GB según OpenAI; requiere margen del entorno | Primera evaluación local si el equipo lo permite |
| gpt-oss:120b | Aproximadamente 65 GB | Una GPU de 80 GB en la referencia oficial | Infraestructura especializada; no descargar por defecto |
Instalar desde la fuente y comprobar el tag
En macOS o Windows, usá el instalador de la página oficial de Ollama. En Linux, su documentación ofrece el script oficial. Podés descargarlo, leerlo y ejecutarlo según sus requisitos; necesitás permisos de instalación. Estos son comandos documentados, no comandos ejecutados por esta publicación.
Cuando Ollama esté instalado y tengas espacio suficiente, comprobá la versión y descargá explícitamente el tag local 20b. El comando de ejecución puede iniciar una descarga si el modelo falta. No uses un tag terminado en -cloud para la prueba offline.
ollama --version
ollama pull gpt-oss:20b
ollama list
ollama show gpt-oss:20b
ollama run gpt-oss:20b
Prueba offline pendiente: una tarea ficticia
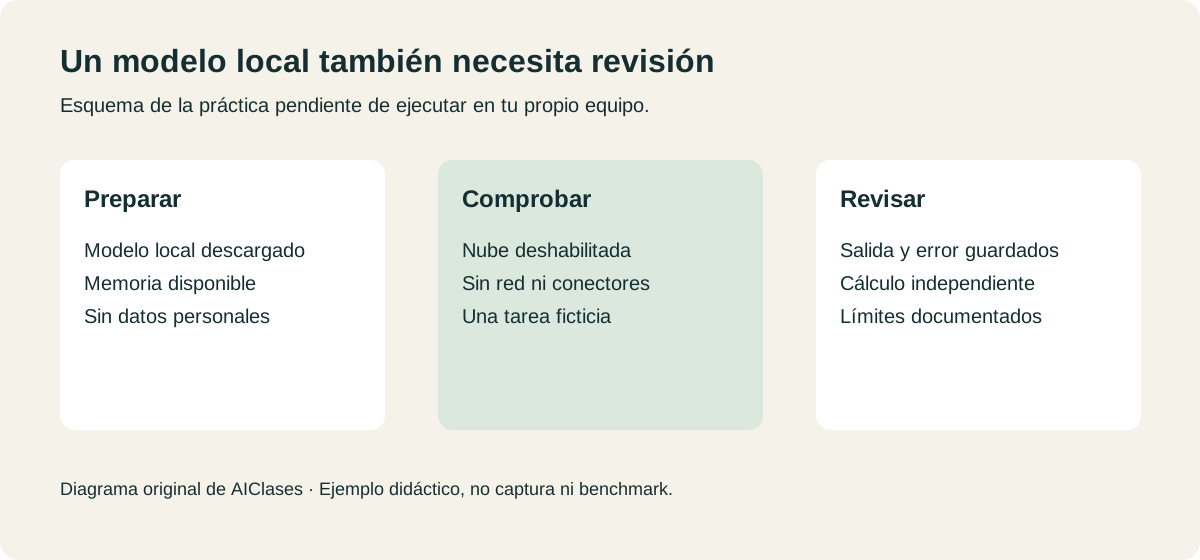
Primero completá la descarga. Deshabilitá las funciones de nube de Ollama según su FAQ y reiniciá el servidor; la documentación ofrece disable_ollama_cloud o OLLAMA_NO_CLOUD=1. No basta con poner una variable sólo en el cliente si el servidor ya estaba iniciado.
Cerrá conectores y desactivá la red para el ensayo. Pedí clasificar estas tres consultas: «Quiero devolver un producto», «¿Cuándo llega mi pedido?» y «Gracias, quedó resuelto». Usá etiquetas devolución, envío o cierre; no generes una respuesta para una persona real.
La referencia didáctica es devolución, envío y cierre, en ese orden. Guardá salida, versión, tag, errores y condiciones de red. Confirmá que la tarea termina sin conexión y que no salió una petición externa. La referencia fue revisada manualmente; aún no hay una ejecución offline, capturas o video de GPT-OSS que prueben este ejercicio.
Clasifica cada consulta ficticia con una etiqueta: devolución, envío o cierre. 1. Quiero devolver un producto. 2. ¿Cuándo llega mi pedido? 3. Gracias, quedó resuelto. Devuelve número y etiqueta. Si falta información, no inventes datos ni acciones realizadas.
Harmony y límites de privacidad
Los pesos se entrenaron con el formato Harmony. Un runtime compatible se encarga de preparar y leer ese formato; no hace falta escribir sus delimitadores en un pedido habitual. Si construís una integración propia, seguí el formato documentado y distinguí mensajes, canales y resultados de herramientas.
La ejecución local no cifra archivos por sí sola ni evita que una extensión, un proxy o un conector envíe datos. Revisá quién puede acceder al servicio, los logs y la carpeta de modelos. Usá datos ficticios para empezar. No expongas el puerto del servicio a otras redes sin configurar el acceso.
Elegí una segunda prueba sólo después de comprobar la primera. Para aprender a formular y revisar pedidos sin instalar un modelo, tenés el curso gratuito ChatGPT para Principiantes. El software, la infraestructura y cualquier API son accesos separados.
Preguntas frecuentes
¿Esta página prueba que GPT-OSS se ejecutó offline?
No. El ejercicio y la comprobación están pendientes; no mostramos una salida, captura ni video inventados.
¿14 GB y 16 GB son el mismo requisito?
No: una cifra describe la descarga del tag; otra es una referencia de memoria. El entorno y el contexto requieren margen.
¿Local significa que cualquier dato está protegido?
No. Revisá servicio, conectores, logs, red y permisos. Usá información autorizada y mínima.
Fuentes y accesos oficiales
Enlaces consultados el 2 de octubre de 2026. Revisa en cada proveedor sus condiciones vigentes.
Material original de Aulas de IA elaborado con asistencia de IA. Practica con los ejemplos y comprueba los resultados. Metodología editorial.